Yapay zekâ modellerinin siber güvenlik alanındaki kullanımının artmasıyla birlikte şirketlerin sistemlerdeki güvenlik açıklarını nasıl tespit edeceği de yeniden gündeme geldi. Palo Alto Networks’ün tehdit istihbaratı ve olay müdahale birimi Unit 42 tarafından yapılan çalışmalar, gelişmiş yapay zekâ modellerinin güvenlik açıklarını bulma konusunda önemli yeteneklere sahip olduğunu ancak tek bir modele güvenmenin ciddi kör noktalar oluşturabileceğini ortaya koydu.
Palo Alto Networks’ün açıkladığı sonuçlara göre karmaşık kurumsal ortamlarda değerlendirilen hiçbir tekil yapay zekâ modeli mevcut güvenlik açıklarının yüzde 40’ından fazlasını yakalayamadı. Bu sonuç, tek bir modelin tek başına kullanılması durumunda açıkların yüzde 60’tan fazlasının tespit dışında kalabileceği anlamına geliyor.
GPT-5.6-Cyber ile Claude Mythos 5 arasındaki fark ne?
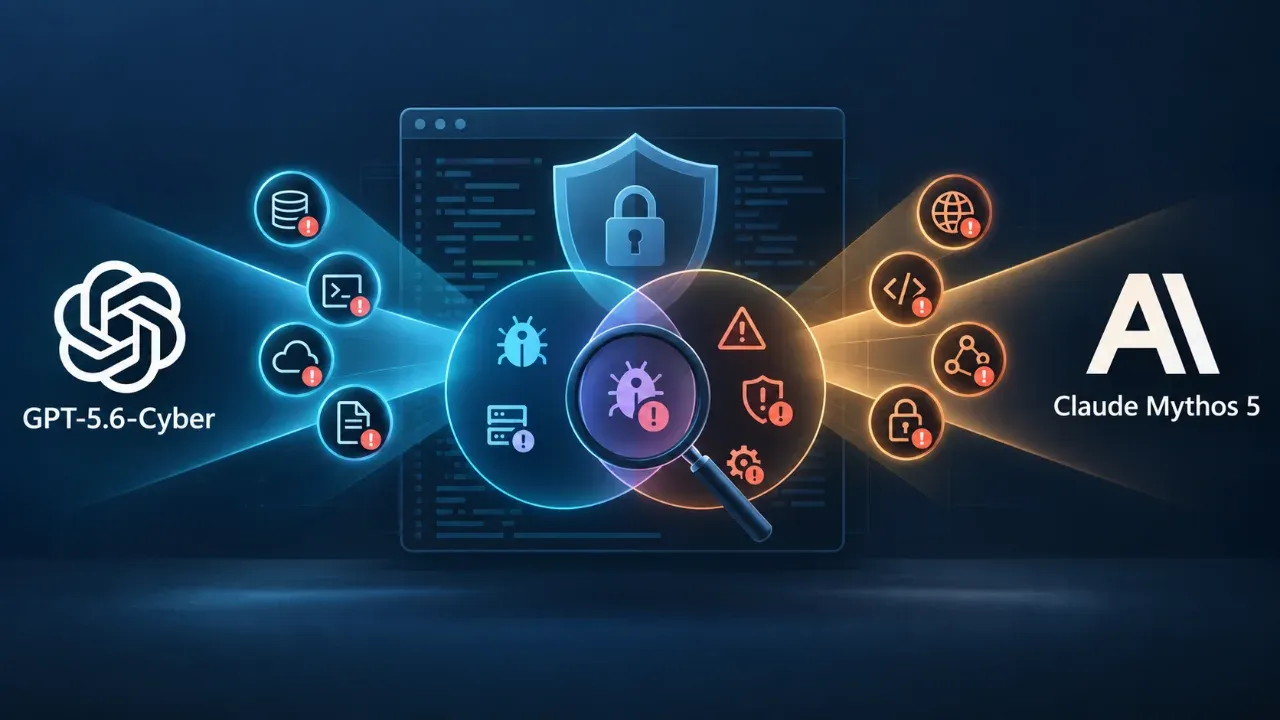
Araştırmada dikkat çeken sonuçlardan biri OpenAI’ın GPT-5.6-Cyber modeli ile Anthropic’in Claude Mythos 5 modelinin ortaya çıkardığı güvenlik açıkları arasındaki fark oldu. Unit 42’nin açıklamasına göre iki modelin belirlediği açıkların örtüşme oranı yüzde 10’un altında kaldı.
Bu verilere göre modellerden birinin tespit ettiği birçok güvenlik açığı diğer model tarafından bulunmadı. Palo Alto Networks, söz konusu sonucu farklı yapay zekâ modellerinin aynı sistem üzerinde farklı zayıflıkları ve saldırı yollarını ortaya çıkarabildiğinin göstergesi olarak değerlendiriyor. Şirket bu nedenle tek bir yapay zekâ modeli yerine birden fazla modelin aynı güvenlik altyapısı içerisinde kullanılmasına yöneldi.
Tek bir yapay zekâ modeli güvenlik açıklarının ne kadarını bulabiliyor?
Unit 42’nin kurumsal kod tabanları ve canlı sistemlerde yaptığı değerlendirmelere göre tek bir modelin tespit oranı yüzde 40 seviyesini aşmadı. Palo Alto Networks, bu sonucu “tek bir yapay zekâ modelinin güvenlik stratejisi olmadığı” yaklaşımıyla açıklarken farklı güvenlik görevlerinin farklı modeller tarafından gerçekleştirilmesinin kapsama alanını artırabileceğini belirtiyor.
Palo Alto Networks’ün yeni yaklaşımında modeller bir orkestrasyon katmanı üzerinden kullanılacak. Sistem, belirli bir güvenlik testini o görev için daha uygun görülen modele yönlendirerek tek tek modellerde ortaya çıkan kör noktaları azaltmayı hedefliyor.
Bulunan güvenlik açıklarının kaçı kritik?
Palo Alto Networks’ün altı aylık şirket içi çalışmalar ve 100’den fazla Unit 42 müşteri çalışmasına dayandırdığı verilere göre Frontier AI Exposure Analysis kullanılan müşteri değerlendirmelerinin tamamında güvenlik riski niteliğinde bulgular tespit edildi. Belirlenen açıkların yüzde 37’si yüksek veya kritik önem seviyesinde sınıflandırıldı.
Şirket ayrıca kendi sistemlerinde yaptığı uygulamada normal şartlarda yaklaşık bir yıllık süreç içerisinde ortaya çıkabileceği belirtilen güvenlik açıklarının üç hafta içerisinde tespit edildiğini bildirdi. Palo Alto Networks, söz konusu yaklaşımın geliştirilmesi ve metodolojinin iyileştirilmesi için 17 milyon dolarlık araştırma-geliştirme yatırımı yapıldığını açıkladı.
CVE kaydı olmayan güvenlik açıkları bulundu mu?
Unit 42 verilerinde üçüncü taraf uygulamalarındaki güvenlik açıkları da dikkat çekti. Palo Alto Networks’e göre üçüncü taraf uygulamalarda doğrulanan güvenlik açıklarının üçte ikisinden fazlasının bilinen bir CVE kaydı bulunmuyordu. Bu nedenle yalnızca daha önce tanımlanmış ve CVE sistemine kaydedilmiş zafiyetleri kontrol eden güvenlik araçlarının bazı sorunları göremeyebileceği belirtiliyor.
CVE, kamuya açıklanan ve standart bir kimlik numarası verilen bilinen güvenlik açıklarının takip edilmesini sağlıyor. Unit 42’nin açıkladığı sonuç ise henüz bilinen bir CVE ile ilişkilendirilmemiş uygulama kaynaklı güvenlik sorunlarının da kurumsal sistemlerde önemli bir risk alanı oluşturduğunu gösteriyor.
Küçük güvenlik açıkları birleştiğinde ne oluyor?
Unit 42, tek başına düşük önem seviyesinde değerlendirilebilecek bazı açıkların aynı saldırı zinciri içerisinde kullanılması halinde etkilerinin önemli ölçüde artabildiğini de açıkladı.
Finans sektöründeki bir çalışmada ödeme bağlantısının kullanıcı kimliğini yeniden doğrulamaması, tek kullanımlık parola kontrolünün atlanması ve oturum yönlendirmesine ilişkin başka bir zayıflık aynı saldırı yolu üzerinde bir araya getirildi. Unit 42’ye göre ayrı ayrı sınırlı görünen bu sorunların birlikte kullanılması, kullanıcıdan herhangi bir işlem yapması istenmeden hesabın tamamen ele geçirilmesine ve ödeme dolandırıcılığı gerçekleştirilmesine imkan verebilecek bir saldırı zinciri oluşturdu.
Yapay zekâ siber saldırıları ne kadar hızlandırıyor?
Yapay zekânın güvenlik ekipleri tarafından kullanılmasının yanı sıra saldırganların da benzer teknolojilerden yararlanması siber saldırıların gerçekleşme süresini kısaltıyor.
Unit 42 tarafından incelenen yakın tarihli bir saldırıda insan tarafından yönlendirilen saldırganın yapay zekâ ajanları yardımıyla 50’den fazla MITRE ATT&CK tekniğini kullandığı belirlendi. Unit 42’ye göre insanlardan oluşan bir ekibin yaklaşık iki haftada gerçekleştirebileceği ölçekteki operasyon 10 saatten kısa sürede yürütüldü. Araştırmacılar olayda paralel çalışan yapay zekâ ajanları, oturumlar arasında bilgi taşıyan yapılandırılmış dosyalar ve yapay zekâ tarafından oluşturulduğu değerlendirilen araçlar tespit etti.
Palo Alto Networks ayrıca yeni açıklanan güvenlik açıklarının saldırganlar tarafından ne kadar hızlı hedef alınabildiğine ilişkin veriler de paylaştı. Unit 42’nin 2026 Küresel Olay Müdahale Raporu’na göre saldırganlar yeni bir CVE duyurulduktan sonraki yaklaşık 15 dakika içerisinde ilgili sistemleri taramaya başlayabiliyor.
Continuous Frontier AI Defense nedir?
Palo Alto Networks, elde edilen sonuçların ardından Unit 42 Continuous Frontier AI Defense adlı yeni güvenlik hizmetini duyurdu. Sistem Anthropic’in Claude Mythos 5, OpenAI’ın GPT-5.6-Cyber modeli ve farklı açık ağırlıklı modelleri ortak bir altyapı içerisinde kullanıyor. Hizmetin temelinde, yapılacak güvenlik görevini uygun yapay zekâ modeline yönlendiren çok modelli bir sistem bulunuyor.
Sistem web uygulamaları, API’ler, bulut altyapıları, kaynak kod depoları ve ağ varlıkları üzerinde güvenlik testleri gerçekleştirebiliyor. Bulunan sorunların gerçek saldırılarda kullanılıp kullanılamayacağı da Unit 42’nin saldırı simülasyonlarıyla doğrulanmaya çalışılıyor. Ardından önceliklendirilmiş düzeltmeler, kod seviyesinde öneriler ve sanal yama tavsiyeleri oluşturuluyor.
Neden birden fazla yapay zekâ modeli kullanılıyor?
Palo Alto Networks’ün açıkladığı test sonuçlarının öne çıkardığı temel nokta, yapay zekâ modellerinin güvenlik açıklarını tespit ederken aynı sonuçları üretmemesi oldu. Tek bir modelin yüzde 40’ın üzerinde kapsama ulaşamaması ve GPT-5.6-Cyber ile Claude Mythos 5’in bulguları arasındaki ortaklığın yüzde 10’un altında kalması, şirketin çok modelli yapıya geçmesinin temel gerekçelerinden biri olarak gösterildi.
Yeni sistemde amaç bir modelin gözden kaçırdığı güvenlik sorununu diğer modelin tespit edebilmesini sağlamak. Böylece yapay zekâ modellerinin tek başına kullanılmasından kaynaklanan kör noktaların azaltılması ve farklı saldırı yollarının aynı güvenlik değerlendirmesi içerisinde incelenmesi hedefleniyor.